存储知识点全景
- 存储
- IO
目录
- 第一章 全景图:一条 IO 的旅程与词汇分层
- 1.1 先建立一张地图:存储金字塔
- 1.2 词汇分层表:每个词都住在某一层
- 1.3 带宽数字基准(建议背下来)
- 1.4 方法论:看任何性能数字先问三问
- 第二章 HDD:理解机械盘,才能理解数据库的”历史包袱”
- 2.1 机械盘是怎么工作的
- 2.2 顺序 vs 随机:天壤之别的物理原因
- 2.3 HDD 时代的两个遗产概念
- 2.4 HDD 今天的定位
- 第三章 SSD 与 NAND 闪存
- 3.1 NAND 闪存的三个物理约束
- 3.2 NAND 闪存的存储方式
- 3.3 FTL(Flash Translation Layer)
- 3.4 为什么消费级 SSD”跑一会儿就跳水”
- 3.5 SSD 与 HDD 的关键差异总结
- 第四章 总线与协议:PCIe、SATA、NVMe 到底谁是谁
- 4.1 PCIe:一条点对点的高速公路
- 4.2 SATA 与 AHCI:上一个时代的遗产
- 4.3 NVMe:为闪存量身定制的协议
- 4.4 NVMe over Fabrics:把方言搬到网络上
- 4.5 带宽预算:一台服务器的账怎么算
- 第五章 Linux IO 栈:一条 write() 从应用到盘的完整路径
- 5.1 五层行政机构
- 5.2 页缓存的读写路径
- 5.3 持久化的语义谱系
- 5.4 从 read() 到 io_uring:syscall 贵在哪、怎么省
- 5.5 观测工具箱
- 第六章 文件系统
- 6.1 文件系统在管什么
- 6.2 崩溃一致性
- 6.3 主流文件系统选型速览
- 6.4 RAID:多盘的组织术(放本章收尾讲最顺)
- 第七章 性能测量:IOPS、吞吐、延迟与 fio 实操
- 7.1 三大指标与它们的关系
- 7.2 fio:磁盘界的 sysbench
- 7.3 稳态:测试前先把盘”打服”
- 7.4 报数合规:三问的落地模板
- 第八章 网络存储通道:RDMA 与”瓶颈常在网”
- 8.1 传统 TCP 的代价
- 8.2 RDMA:远端内存直接读写
- 8.3 NVMe-oF:把”盘的方言”搬到网上
- 8.4 零拷贝全家福(本机侧的配合)
- 8.5 本章结论:分布式带宽的记账公式
- 第九章 分布式存储基础:把 N 台机器的盘拼成一个系统
- 9.1 为什么分布式:可用性与扩展性
- 9.2 通用骨架:元数据层 + 数据层
- 9.3 冗余:三副本 vs 纠删码(EC)
- 9.4 一致性:副本之间怎么不打架
- 9.5 心跳、故障与再平衡
- 9.6 三大经典系统对号入座
- 9.7 聚合带宽的诚实算法
- 第十章 复盘:存储如何塑造了数据库
- 10.1 页(page)大小的因果链
- 10.2 B+ 树:为”减少随机 IO”而生
- 10.3 LSM:为”把随机写变成顺序写”而生
- 10.4 WAL 与 fsync:持久化的最后一公里
- 10.5 doublewrite:文件系统不懂 SSD 的”半页”问题
- 10.6 buffer pool 与冷热分层:金字塔的中间层
- 10.7 一张因果总表
- 第十一章 KVCache Store 与 AI 时代存储
- 11.1 背景:PD 分离与 KV Cache
- 11.2 架构四层(对照第 9 章骨架)
- 11.3 为什么 KVCache 负载”特殊”(用前十章逐条解释)
- 11.4 三个代表系统
- 11.5 学习路线收官
第一章 全景图:一条 IO 的旅程与词汇分层
1.1 先建立一张地图:存储金字塔
计算机里所有能放数据的地方,按”离 CPU 多近、多快、多贵、多持久”排成一个金字塔:
寄存器        ~1ns        几十字节
CPU L1/L2/L3  1~30ns      几 MB ~ 几百 MB
内存 DRAM     ~100ns      几十~几百 GB,~几十到几百 GB/s,断电即丢
────────────────────── 以下是本系列说的"存储" ──────────────────────
NVMe SSD      ~100us      微秒级延迟,单盘几 GB/s,断电保留
SATA SSD      ~100us      同样是闪存,但被接口卡住
HDD 机械盘    ~10ms       毫秒级(一次寻道顶 10 万次内存访问)
磁带/冷归档   ~秒~分钟    最便宜,用于归档
用数据库的眼光看这张图,立刻能读出三件事:
- 内存和 SSD 差 1000 倍延迟——这就是 buffer pool / shared buffer 存在的全部理由:哪怕 99% 命中率,剩下 1% 落盘都会拖垮整体 RT。
- SSD 和 HDD 差 100 倍延迟——B+ 树”减少随机 IO”的设计哲学,本质是在为 HDD 的 10ms 寻道赎罪。你学过的很多”数据库常识”,其实是”HDD 时代的常识”(第 11 章展开)。
- 断电是否丢数据是内存和存储的分界线——所以数据库才需要 WAL + fsync 这套”把内存里的修改钉到持久介质”的仪式。
1.2 词汇分层表:每个词都住在某一层
社区讨论里 NVMe、PCIe、RDMA、dist 满天飞,其实它们分别住在不同的层。一条 IO 从应用出发的完整路径是:
应用程序(MySQL / KVCache store / 你的代码)
   ↓ 系统调用 read/write/io_uring
Linux 内核 IO 栈(VFS → 页缓存 → 文件系统 → 块层)
   ↓
协议(NVMe / SATA / SAS)     ← "盘说什么方言"
   ↓
总线(PCIe / SATA 线缆)      ← "方言跑在哪条路上,路有限速"
   ↓
介质(NAND 闪存 / 磁盘片) ← "数据物理上怎么存"关键认知:每一层都有自己的吞吐天花板,所以任何性能数字都必须说明”测在哪一层”。盘的 spec 数字、fio 裸盘数字、应用层读到的数字,可以差好几倍。这就是别人质疑”40GB/s 真的假的”的技术根源。
| 词汇 | 住在哪层 | 一句话解释 | 数据库类比 |
|---|---|---|---|
| HDD / SSD / NAND | 介质 | 数据物理存哪、多快 | — |
| NAND page/block | 介质内部结构 | 闪存的最小读/擦单位 | 类比页和区段 |
| FTL | 盘内固件 | 闪存翻译层,盘里的”迷你 LSM” | LSM 引擎 |
| NVMe | 协议 | 为闪存设计的高速通信方言 | 专为 MySQL 优化的 wire protocol |
| AHCI | 旧协议 | SATA 时代的方言,单队列,为机械盘设计 | 老的、单请求排队的协议 |
| PCIe | 总线 | 盘插的高速通道,版本决定限速 | 机房网线带宽 |
| SATA / SAS | 总线+协议 | 旧接口,SATA 上限 0.6GB/s | 老网卡 |
| VFS / 页缓存 / 块层 | 内核 | Linux 管文件和 IO 的三层行政机构 | — |
| O_DIRECT / fsync | 系统调用语义 | 绕缓存 / 强制落盘 | redo log 的持久化保证 |
| io_uring / SPDK | 高性能 IO | 批量提交 / 干脆绕开内核 | 连接池 / 独占直连 |
| RAID | 单机多盘组织 | 多块盘拼冗余和性能 | — |
| RDMA | 网络 | 远端内存直接读写,绕内核协议栈 | 高性能主从复制通道 |
| NVMe-oF | 网络协议 | 把 NVMe 方言直接跑网上 | DB 直连分布式存储 |
| fio | 工具 | 磁盘压测标准工具 | sysbench / pgbench |
| dist | 缩写 | 网友说 distributed(分布式)的缩写,不是术语 | — |
1.3 带宽数字基准(建议背下来)
看懂一切性能宣称的锚点。没有这些数,你无法判断一个数字是”猛”还是”吹”:
| 对象 | 数量级 | 备注 |
|---|---|---|
| HDD 顺序读 | ~0.2 GB/s | 机械盘天花板 |
| SATA 接口 | ~0.6 GB/s | 接口上限,再快的 SSD 插上也卡在这 |
| PCIe 3.0 x4 NVMe | ~3.5 GB/s | 老一代消费级 |
| PCIe 4.0 x4 NVMe | ~7 GB/s | 当前主流,企业级可到 7~14 |
| PCIe 5.0 x4 NVMe | ~14 GB/s | 新一代,3FS 类系统用 |
| 单机内存带宽 | 200~400 GB/s | 比盘快一个数量级以上 |
| 100Gb 网卡 | ~12.5 GB/s | 分布式系统的真实瓶颈常在网不在盘 |
| 8 盘 PCIe 4.0 服务器 | 理论 ~56,实测 ~40 GB/s | ”单机 40GB/s”的典型出处 |
一个心算技巧:PCIe 每代每 lane 约 1GB/s 上下(3.0≈0.98,4.0≈1.97,5.0≈3.9),NVMe 盘占 x4,所以单盘上限就是 4×这个数。看到”单机 40GB/s”,心算一下:40 ÷ 7 ≈ 6 张 PCIe 4.0 盘聚合——嗯,合理,但必是多盘聚合,绝无可能是单盘。
1.4 方法论:看任何性能数字先问三问
这是全书最重要的一节。以后你看到任何吞吐宣称(简历、论文、社区帖、面试官的暗示),都自动过一遍:
- 测在哪一层?
介质 spec(纸面)→ fio 裸盘 → 文件系统之上 → 应用层(含序列化、锁、内存拷贝)。越往右数字越缩水。 - 单点还是聚合?
单盘 / 单机多盘 / 集群 N 台总和(dist)。单盘数字最硬,集群数字随规模想多大有多大,含金量最低。 - 什么负载?
顺序大块读(最漂亮的数字)/ 随机小块(最接近真实业务)/ 混合读写(最惨)。宣称数字几乎永远是顺序大块读。
评论区那句”40GB/s 是盘的带宽还是 dist 的带宽”,其实就是第 1、2 问的口语版。而”真的假的”的答案是:如果是”单机 6~8 张 PCIe 4.0 盘 fio 顺序大块读聚合”,那它不但真实,甚至平平无奇;但如果是”单张盘”或者”应用到应用”,那就是吹的。数字不会说谎,但口径会说谎。
第二章 HDD:理解机械盘,才能理解数据库的”历史包袱”
虽然 SSD 已经是绝对主流,但数据库世界的大量设计(B+ 树、顺序 WAL、预读、聚簇索引)都是被机械盘”逼”出来的。不学 HDD,你就只知其然。
2.1 机械盘是怎么工作的
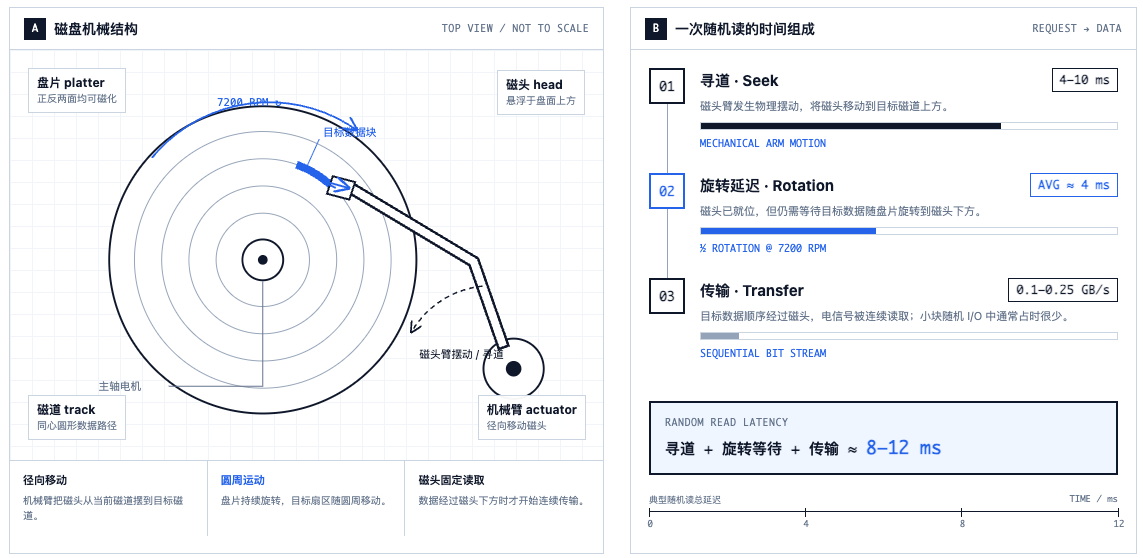
一块 HDD 由若干盘片(platter)组成,每个盘片正反两面都有磁介质,由主轴电机带动恒速旋转(7200 RPM = 每分钟 7200 转)。数据磁化在盘片上一个个同心圆的磁道(track)里。每面盘片上方悬着一个磁头(head),读写时要先:
- 寻道:磁头臂像黑胶唱片机那样物理摆动,把磁头移动到目标磁道上方——机械动作,典型耗时
410ms; - 旋转延迟:等盘片转过来,让目标数据转到磁头下方——平均是半圈的时间,7200 RPM 下约 ~4ms;
- 传输:数据顺序流过磁头下方,速度约 0.1~0.25 GB/s。
一次随机读 ≈ 寻道 + 旋转延迟 + 传输 ≈ 8~12ms。这就是 HDD 随机 IO 慢的物理根源:不是电在慢,是机械臂在慢、盘片在等。
2.2 顺序 vs 随机:天壤之别的物理原因
- 顺序读:磁头不摆动,数据流连续流过磁头 → 0.2 GB/s,能吃满接口。
- 随机读:每次都寻道 + 等转 → 每秒最多约 100
150 次随机 IO(IOPS),且每次还只能拿 4KB64KB。
差距是上千倍。这是存储世界最重要的一组对比,也是后面一切故事的主角:
- WAL / redo log 为什么是顺序追加?因为顺序写在 HDD 上比随机写快 100 倍——先把随机写攒成顺序写,这就是日志的使命。
- B+ 树为什么矮胖(3~4 层管千万行)?因为每层就是一次随机读 = ~10ms,树越高查询越慢;节点为什么一整页 16KB?因为寻道太贵,一次寻道多拿点数据才划算(这就是预读思想的固化)。
- 预读(read-ahead):内核和存储引擎发现你在顺序读,就自动多读后面几段——因为”多读一点”在 HDD 上几乎是免费的(数据反正会从磁头下转过去),而再寻一次道是天价。
2.3 HDD 时代的两个遗产概念
IOPS 与带宽的关系:HDD 上两者被机械绑死——100 IOPS × 4KB = 每秒才 0.4MB 随机;顺序时却 200MB/s。所以老 DBA 优化数据库,本质上是在减少寻道次数(这是理解老式数据库调优的钥匙)。SSD 时代这个耦合被解开(第 3 章),所以很多老经验失效。
SMR(叠瓦式记录):为了让盘片密度更高,磁道像屋顶瓦片一样叠着写,导致改写一段数据可能要连着重写后面一串——随机写性能雪崩。它是 HDD 里的”写放大”亲戚,也提醒你:买盘(尤其冷数据归档盘)要看清是不是 SMR。
2.4 HDD 今天的定位
单盘 0.2 GB/s、100 IOPS 的指标在 SSD 面前毫无还手之力,但 HDD 每字节成本仍比 SSD 低数倍,所以它退守到冷数据、归档、对象存储底层:照片视频的冷层、备份、训练数据集的仓库。云厂商的数据中心里硬盘依然是按 EB 计的——你刷小红书时热数据在 SSD/内存,三年前的笔记在 HDD 集群里躺着。理解这个分层,就看懂了现代数据系统的”冷热分层”为什么长这样(数据库里对应 buffer pool → 磁盘 → 归档表空间)。
第三章 SSD 与 NAND 闪存
3.1 NAND 闪存的三个物理约束
NAND 闪存的存储单元是”浮栅晶体管”:往栅极里注入/抽出电荷代表 1 bit。这个朴素的机制带来三条铁律:
- 读的最小单位是 page(典型 4~16KB),读非常快(微秒级)。
- 写的最小单位也是 page,而且一个 page 只能”从空写到满”,不能原地覆盖。想改一个字节?只能把整页读出来、改好、写到另一个空页去。
- 擦除的最小单位是 block(几十上百个 page 组成,MB 级),擦除很慢,而且擦一次少一次:每个 block 的可擦写次数(P/E cycles)有限——SLC ~10 万次、MLC ~3000 次、TLC ~1500 次、QLC ~几百到 1000 次。
第三条推出了消费级市场的规律:容量越大的单元(一个栅里塞 3、4 bit),越便宜但越慢、越短命。企业级 TLC/QLC 靠更好的主控和固件弥补。
NAND 闪存是 SSD 内部真正保存数据的介质
┌──────────────────────── SSD ────────────────────────┐
│                                                    │
│  SSD 控制器 ── DRAM / SRAM 缓存                    │
│      │                                             │
│      ├── NAND 通道 0 ── NAND 芯片                  │
│      ├── NAND 通道 1 ── NAND 芯片                  │
│      ├── NAND 通道 2 ── NAND 芯片                  │
│      └── NAND 通道 3 ── NAND 芯片                  │
│                                                    │
└────────────────────────────────────────────────────┘
3.2 NAND 闪存的存储方式
TLC 和 SLC 都是 NAND 闪存的存储方式。区别不在于 Cell 数量,而在于:每个 Cell 存多少 bit,以及需要区分多少种电压状态。
NAND 的基本存储单元叫 Cell。Cell 通过保存不同数量的电子,形成不同的阈值电压。读取时,控制器并不是直接观察“0 或 1”,而是测量 Cell 的阈值电压,然后判断它属于哪个电压区间。
- 写入:向 Cell 注入电子,调整阈值电压
- 读取:测量阈值电压,判断数据
- 擦除:释放电子,让 Cell 回到初始状态
SLC 和 TLC 的根本区别,就是把电压范围切成几档。
- SLC(Single-Level Cell):一个 Cell 保存 1 bit
- TLC(Triple-Level Cell):一个 Cell 保存 3 bit,28 = 8种可区分的阈值电压状态
3.3 FTL(Flash Translation Layer)
操作系统以为自己在对一块”可随机覆盖读写的地址空间”(LBA,逻辑块地址)做 IO,但 NAND 物理上根本不支持覆盖写。中间靠盘里的固件 FTL(Flash Translation Layer) 打圆场,它维护:
- 映射表:LBA → 物理地址的映射,像一个页表。这就是为什么 SSD 掉电重启要”重建映射”(冷启动慢),也是掉盘数据损坏的经典现场。
- 垃圾回收(GC):block 里混着”有效页”和”被覆盖后作废的页”。要腾出可擦的整块,FTL 把有效页搬到新地方,把整块擦掉——和 LSM 的 compaction 一模一样:compaction 也是把有效的数据搬走、整层清理掉空间。
- 磨损均衡(Wear Leveling):写热度摊到所有 block 上,避免热点 block 先老死——像分库分表里的热点 key 分散。
- TRIM:操作系统删除文件时通知盘”这些 LBA 作废了”,FTL 才敢在后台悄悄回收。没 TRIM 的盘越用越慢,就是这个原因。
由此产生最重要的指标——写放大系数(WAF)= 实际写入 NAND 的数据量 / 应用写入的数据量。GC 搬移有效页、映射更新都是额外写入,典型 1.5~5 倍。它和 LSM 的写放大互为镜像,数据库的同学看一眼就懂。
3.4 为什么消费级 SSD”跑一会儿就跳水”
消费级盘拿一部分 TLC 容量临时伪装成 SLC 当写入缓存(就叫 SLC cache):来者不拒、先飞快写进这段缓存,后台再慢慢”降格”成 TLC 落盘。缓存写满之后,写入必须走真实的 TLC 慢路径,速度直接腰斩再腰斩——这就是 fio 长时间压测后”速度跳水”的机制。所以任何 SSD 性能数字都必须说”稳态(steady state)“还是”峰值(fresh out of box)“,这是存储版的”新机器跑分”。企业盘靠两个手段避免跳水:
- OP(Over-Provisioning,预留空间):标 7TB 实际 NAND 是 8TB,多出的 7% 给 FTL 当 GC 机动空间,稳态性能平稳得多;
- 掉电保护电容:写回盘内 DRAM 缓存的数据在断电瞬间靠大电容刷进 NAND。没有这个的盘,断电会丢已 ack 的数据——数据库生产环境必须用带 PLP(power loss protection)的企业盘,这不是玄学是事故换来的规矩。
3.5 SSD 与 HDD 的关键差异总结
| 维度 | HDD | SSD | 对数据库的影响 |
|---|---|---|---|
| 随机 vs 顺序 | 差 100~1000 倍 | 差距缩小到几倍 | ”必须避免随机 IO”的教条松动 |
| 延迟 | ~10ms | ~100us | RT 里”落盘”的代价从毫秒变微秒 |
| 稳态性能 | 恒定 | 受 GC/SLC cache 影响波动 | 压测要”先填一遍盘再看稳态” |
| 写入代价 | 均匀 | 有寿命、有 WAF | 写密集场景要考虑寿命预算 |
| 原地更新 | 可以 | 不行(FTL 模拟) | 更新重负载下 FTL/LSM 的 GC 压力都变大 |
最后留一个心智模型收尾:SSD ≈ 一只自带 GC 和寿命管理的迷你 LSM。读快、顺序写快、随机写靠 FTL 兜底但有放大、稳态 ≠ 峰值。记住这个模型,后面看 KVCache store 的设计(第 12 章)会处处似曾相识。
第四章 总线与协议:PCIe、SATA、NVMe 到底谁是谁
一句话先行:PCIe 是路,NVMe 是跑在路上的方言,SSD 是住在路尽头的仓库。路的限速再高,方言低效也白搭;方言再高效,路是单车道也快不了。
4.1 PCIe:一条点对点的高速公路
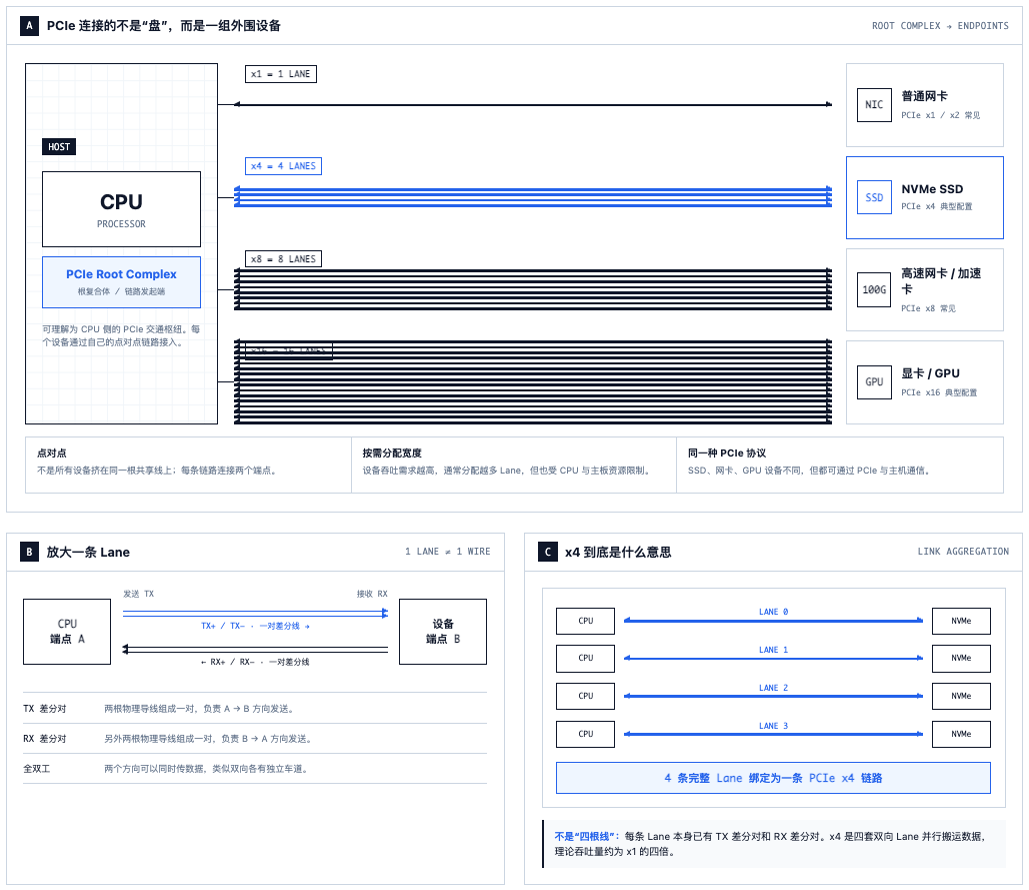
PCIe 是 CPU 与外围设备之间的主通道,不只是盘——网卡、GPU、加速卡都插在上面。它的几个关键概念:
Lane( lane = 车道):PCIe 是串行点对点链路,一条 lane 包含一对发送一对接收线。设备按占用的 lane 数标注:x1(网卡常见)、x4(NVMe 盘)、x8/x16(GPU、100G 网卡)。
每代带宽(单向、每 lane,十进制近似):
| 代数 | 每 lane 带宽 | x4 总带宽 | NVMe 盘实测顺序读 |
|---|---|---|---|
| PCIe 3.0 (2010) | ~1 GB/s | ~4 GB/s | ~3.5 GB/s |
| PCIe 4.0 (2017) | ~2 GB/s | ~8 GB/s | ~7 GB/s |
| PCIe 5.0 (2019) | ~4 GB/s | ~16 GB/s | ~14 GB/s |
拓扑与预算:CPU 的 PCIe lane 总数有限(典型服务器 CPU 80~128 条),不够用时设备通过 PCIe Switch(类似交换机)分享上行带宽。8 张 x4 盘全直连 CPU 各占 x4 没问题;但 24 张盘就要过 switch,多张盘共享 x16 上行——盘插得多不代表带宽线性涨,这是”单机聚合带宽”测算时必须看的拓扑。另外交换芯片本身有转发上限,也是常见的隐形瓶颈。
降速(degradation):盘与 CPU 的链路会协商到双方都支持的最高代数,散热不好或线路质量差会降到低代——宣称 PCIe 5.0 的盘实际跑在 3.0 上,带宽直接只剩 1/4。排查时用 nvme 命令或 lspci 看 link status(LnkSta)。
4.2 SATA 与 AHCI:上一个时代的遗产
SATA 是 2003 年定下的盘接口,理论 0.6 GB/s,物理上一条 SATA 口只连一个设备。它绑定的协议 AHCI 有个致命设计:全系统只有一条队列,深度 32——因为它是为机械盘设计的,机械盘一次也处理不了 32 个请求(寻道都忙不过来)。
闪存时代这成了枷锁:NAND 内部是并行的(多个 die 同时读),一个 4KB 请求几十微秒就能完成,单队列深 32 意味着主机一次最多压给它 32×4KB,盘喂不饱,闪存的并行能力全浪费。所以 SATA SSD 最多只能跑出 0.55 GB/s 左右——被接口和协议双重卡死。这就是”再快的 SSD 插 SATA 口也只能 0.5 GB/s”的原因。SAS 是服务器版 SATA,双口冗余,现在也主要剩历史存量。
4.3 NVMe:为闪存量身定制的协议
NVMe(2008 立项、2011 发布 1.0)干的事一句话概括:把”单队列深 32”改成 64K 个队列、每队列深 64K,直接挂在 PCIe 上跑。
为什么这个改动是质变:
- 多队列:每个 CPU 核可以有自己的提交队列(SQ)和完成队列(CQ),IO 提交不再需要跨核抢锁
- 深队列:上万深度可以把 SSD 内部的并行 die、通道(channel)全部喂满,闪存吞吐是”并行度 × 单通道速度”的乘积,队列浅就打不满乘法;
- 中断聚合、MSI-X:完成事件可以攒批通知 CPU,减少中断风暴
由此,NVMe 盘的速度 = 介质速度、PCIe 带宽、队列深度三者取最小。日常说”NVMe SSD”实际是”NVMe 协议 + PCIe 总线 + NAND 介质”的打包缩写,这也是社区词汇混用的根源。
4.4 NVMe over Fabrics:把方言搬到网络上
NVMe-oF = 把 NVMe 协议报文封装后跑在网络(RDMA 或 TCP)上, initiator(发起端)像访问本地盘一样访问远端的 NVMe 盘。意义:远端存储跳过”远端文件系统 + 块设备”的多层翻译,直接说方言,延迟更低、路径更短。分布式存储的某些产品(如NVMe-oF target 模式的 Ceph、各类”盘阵直通”方案)就靠它。
4.5 带宽预算:一台服务器的账怎么算
综合本章,给你一个单机带宽的”记账模板”,以后看到单机吞吐宣称可以自己审计:
单机聚合带宽 ≤ min(
    盘数 × 单盘带宽,             # 介质与协议上限
    PCIe 上行总带宽,              # 拓扑限制(switch 或 CPU lanes)
    CPU 处理 IO 的能力,           # 中断、软中断、拷贝
    内存带宽的余量
)
例:8 张 PCIe 4.0 x4 盘直连 CPU → 盘侧 56 GB/s,PCIe 够,理论 56;实际受 CPU 中断/调度、FTL 稳态等影响,实测 40 GB/s 左右——这就是社区里”单机 40GB/s”的合理出处:8 盘级服务器的顺序读聚合,一个不多见的、但毫不魔幻的数字。
第五章 Linux IO 栈:一条 write() 从应用到盘的完整路径
这章是全书”软件层”的主干。理解了这条路径,你才能理解 O_DIRECT、fsync、页缓存、io_uring 这些数据库绕不开的词,也才能理解”fio 数字和应用层数字差在哪”。
5.1 五层行政机构
一条 write() 从应用到 NAND,要穿过五层:
write() 系统调用(用户态 → 内核态,一次上下文切换)
  ↓
① VFS(虚拟文件系统):统一接口层,认出"这是个 ext4 文件"
  ↓
② Page Cache(页缓存):内核的"buffer pool",4KB 一页
  ↓
③ 文件系统(ext4/XFS):维护 文件偏移 → 磁盘块 的映射(inode/extent)
  ↓
④ Block Layer(块层):把"写这些块"变成请求 bio,排队、合并、调度
  ↓
⑤ 驱动(NVMe):把请求塞进 SQ 环,盘干完活回 CQ 环,中断通知
  ↓
盘内 FTL → NAND
数据库人读这张图最该产生的两个反应:
- 页缓存 = 一个我不受控的 buffer pool。它对读是好事(免费缓存),对写却意味着”write() 返回 ≠ 落盘”——数据停在内存里,内核认为”待会儿再刷”。这正是数据库 redo log 必须 fsync 的原因:数据库要自己做持久化承诺,不能依赖内核的”待会儿”。
- 我写一条数据竟然要过五个衙门。每个衙门都有拷贝、加锁、排队。所谓高性能存储系统(SPDK、io_uring),本质都是在裁衙门。
5.2 页缓存的读写路径
读:write 不涉及。读时先查页缓存,命中直接返回(内存速度),未命中才发 IO 到块层,读回来放页缓存再拷给应用。
写(默认 write-back 模式):write() 把数据写进页缓存,标记脏页(dirty),立即返回成功。之后内核的 flusher 线程按”脏页比例/年龄”阈值把脏页成批刷盘。两个后果:
- 程序崩了数据大概率还在(页缓存属于内核,进程死了缓存不死);机器断电/内核崩溃,数据就没了——“写成功”和”持久”之间隔着一个待刷盘的窗口。
- 大量脏页集中回写时会看到 IO 抖动,
/proc/sys/vm/dirty_ratio等参数控制水位。
5.3 持久化的语义谱系
| 语义 | 行为 | 代价 | 类比 |
|---|---|---|---|
| write() | 进页缓存就返回 | 快,不持久 | ”提交到事务缓冲” |
| fsync(fd) | 把该文件所有脏页和相关元数据刷到稳定存储才返回 | 一次真实落盘 | ”提交日志并确认” |
| fdatasync(fd) | 只刷数据,跳过不必要的元数据(如文件大小不变时的 mtime) | 略便宜 | ”只提交事务本身” |
| O_SYNC 写 | 每次 write 自带落盘 | 每条都付一次 fsync 代价 | ”每语句一提交” |
| O_DIRECT | 绕开页缓存,直通块层 | 省一份内存拷贝,但绕缓存不等于持久! | “跳过 buffer pool 直接裸写” |
最经典的误区标在最后一行:O_DIRECT 只解决”绕缓存”,不解决”何时持久”。InnoDB 用 O_DIRECT 之后依然要靠 redo log fsync 保证持久性。所以 InnoDB 的组合拳是:O_DIRECT(避免数据页在页缓存 double 缓存浪费内存、避免内核回写时机不可控)+ 每次 commit fsync redo log(拿持久化承诺)。
page cache 的双重缓存问题:如果数据库自己管 buffer pool(InnoDB 就是),内核页缓存又存一份,同一页在内存里躺两份,浪费一半内存且增加一次拷贝。这就是数据库偏好 O_DIRECT 的核心动机。
mmap:把文件映射进进程地址空间,读文件 = 读内存,缺页时内核自动拉数据。省拷贝,但缺页中断不可控、写入持久化语义同样要 msync,生产数据库基本不用它管理热数据页,反而在分析场景(如某些列存、索引只读段)常见。
5.4 从 read() 到 io_uring:syscall 贵在哪、怎么省
传统同步 IO 一次 read = 一次上下文切换(用户态→内核态)+ 一次内存拷贝(页缓存→用户缓冲区)。单次才几微秒,看起来便宜,但在百万 IOPS 时 CPU 全在切换和拷贝上,盘反而空闲。
- 多线程/epoll:用并发把”等盘”的时间盖住——盘的并行能力越来越强(NVMe 64K 队列),并发灌满它是第一个思路。
- io_uring(2019,Linux 5.1+):应用和内核共享两个环——提交环(SQ) 应用批量塞请求、完成环(CQ) 内核批量回结果。一次系统调用提交一批请求,切换和拷贝被摊薄到每个请求几乎为零。它是”批量提交 + 异步收割”,和你熟悉的 group commit 心智模型完全一致:攒一批、一次提交、分摊成本。现代 DB、KVCache 存储(如 3FS 的 IO 路径)基本都迁移到了 io_uring。
- SPDK:更激进的裁衙门方案——用户态直接驱动 NVMe(绕过整个内核块层),轮询代替中断(专核 busy-poll)。延迟最低、CPU 独占换取的吞吐最高,代价是编程模型复杂、盘被独占。高性能专用系统才用。
5.5 观测工具箱
| 工具 | 看什么 |
|---|---|
| iostat -x 1 | 每盘 r/s、w/s、rMB/s、wMB/s、await、util% |
| pidstat -d | 按进程 IO,定位”谁在打盘” |
| blktrace / bpftrace | 块层延迟分解(排队时间 vs 盘执行时间) |
| iotop | 实时按进程 IO 的 top |
| /proc/meminfo(Dirty/Writeback) | 脏页存量,判断回写压力 |
| nvme smart-log | 盘健康、剩余寿命、链路降速 |
两个高频陷阱(老 DBA 也常踩):
- iostat 的 util% 满不等于盘饱和。util% 是”队列非空的时间占比”,HDD 时代近似”忙”,但 NVMe 天生并行,100% util 时吞吐可能还在涨。看吞吐和 await 比 util 更可靠。
- await 高不一定是盘的锅。await 是”从进块层到完成”的总耗时,排队太深、CPU 饿死 flusher、上游锁竞争都会抬高它。用 blktrace 拆”排队段 vs 盘执行段”再下结论——这和”慢查询不一定是执行慢,可能在等锁”是同一套排查逻辑。
第六章 文件系统
文件系统(File System, FS)解决的问题:把”一块只能按扇区读写的无结构磁盘”组织成”按路径找文件的世界”。它本质上是一个存放在磁盘上的小型数据库:inode 表是它的”系统表”,目录是它的”索引”。
6.1 文件系统在管什么
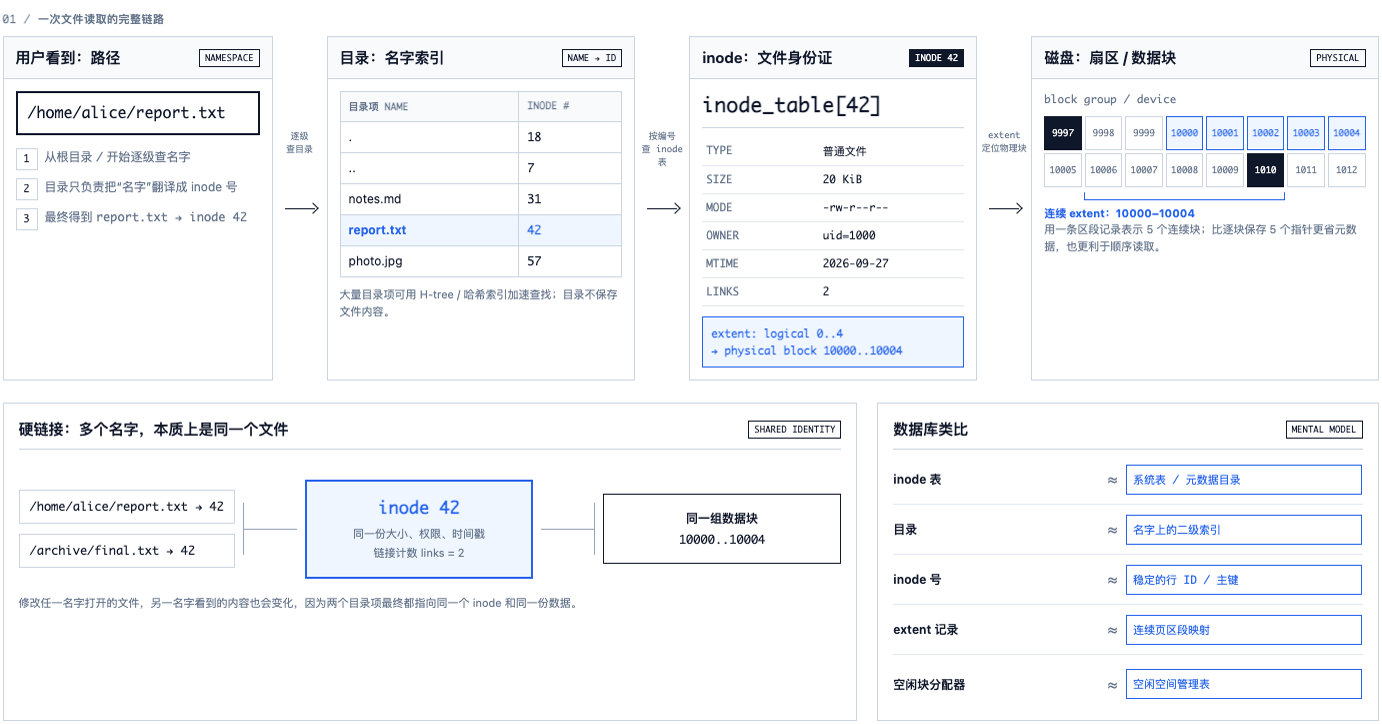
一个文件 = inode(元数据)+ 一串数据块。
- inode:文件的身份证——大小、权限、时间戳、指向数据块的指针。它和文件名解耦,文件名只是目录里的一条”inode 号 → 名字”的记录(所以硬链接就是多个名字指向同一 inode,这也是为什么改一个硬链接文件另一个也”变”——它们本来就是同一份数据和元数据)。
- extent(区段):老 FS(ext2)给每个文件存”块指针数组”,大文件的指针表本身就占好多块;现代 FS(ext4/XFS)改存连续区段(“这个文件占用从块 10000 起连续 500 块”)。连续区段还顺带恢复了顺序读性能——分配时尽量连续,和数据库”顺序分配 extent 避免碎片”如出一辙。
- 目录:一棵树,每个目录项 = 名字 → inode 的映射,本质是 B+ 树/哈希索引(ext4 用 H-tree,就是 B 树变体)。
数据库类比总结:inode 表 = 系统表;目录 = 二级索引;extent 分配器 = 空闲空间管理表。
6.2 崩溃一致性
断电瞬间,正在写的 FS 处于”数据写了一半、元数据写了另一半”的随机状态,重启后可能出现”文件大小变了但数据是旧的”这类怪象。FS 的应对是日志(journal)——先写下”我要改哪些元数据”的意图,再动手改,崩溃后按日志补齐或回滚。这不是巧合,这就是 write-ahead 的同一种思想,只是元数据是它的”事务”:
- journal 模式三档(ext4 挂载选项,影响性能与安全):
data=journal:元数据+数据都进日志——最安全,写两遍最慢;data=ordered(默认):只日志元数据,数据先于元数据刷盘——日常均衡;data=writeback:只日志元数据,数据何时落盘不管——最快,崩溃可能见旧数据。
- CoW 文件系统(ZFS/btrfs):不原地改、永远写新版本再原子切换指针,天然崩溃一致,顺带获得快照和校验能力。就像 append-only + 原子指针切换。ZFS 顺带做了端到端校验和(每块存 checksum,读时验证)
数据库人最重要的结论:FS 日志只保证”文件系统结构不坏”,不保证”我的文件内容完整”。应用一个事务写到一半断电,FS 重启后完好无损,但你的文件只有半条事务。所以数据库必须在 FS 之上再造一层(redo log + doublewrite)。
6.3 主流文件系统选型速览
| FS | 特点 | 谁在用 |
|---|---|---|
| ext4 | 最主流,稳,extent + journal,中庸 | 默认选择 |
| XFS | 大文件、高并发分配强,元数据并行佳 | RHEL 默认;数据库/大文件 |
| ZFS/btrfs | CoW、快照、校验和、子卷 | NAS(TrueNAS)、容器存储 |
| tmpfs | 纯内存 FS | /dev/shm,临时数据 |
数据库/存储系统的常见姿势:要么选 XFS + 调整挂载参数;要么干脆绕过 FS(如直接管理裸设备的 KV 存储、SPDK blobstore),裁掉这层衙门。
6.4 RAID:多盘的组织术(放本章收尾讲最顺)
单机数据可靠的另一半是盘组织问题。盘会坏,坏了一台机器的数据就没了;盘也慢,一盘 7GB/s 要打 40GB/s 就要聚合。RAID(独立磁盘冗余阵列) = 多盘按某种策略拼起来同时解决”坏不坏”和”快不快”:
| 级别 | 组织方式 | 容错 | 空间利用率 | 写惩罚 |
|---|---|---|---|---|
| RAID 0 | 纯条带(数据轮流分给各盘) | 0 坏 | 100% | 1× |
| RAID 1 | 镜像(两盘互拷) | 1 块 | 50% | 写两份 |
| RAID 5 | 条带+分布式校验 | 1 块 | (n-1)/n | 写要同时改数据+校验(读改写,约 4 次 IO) |
| RAID 6 | 双校验 | 2 块 | (n-2)/n | 约 6 次 IO |
| RAID 10 | 先镜像后条带 | 每对坏 1 | 50% | 2×,写快读快,DB 时代经典 |
RAID 5/6 的写惩罚:一次小块写在”老值新值都要读出来才能算新校验”时变成读旧数据 + 读旧校验 + 写新数据 + 写新校验 = 4 次 IO。所以随机写密集的数据库从来不上 RAID5,上 RAID10。
注意”分布式时代的观念迁移”:单机 RAID 卡方案在云和分布式时代在退化——大型分布式存储干脆 JBOD(不组 RAID,盘直挂),把冗余上移到集群层(三副本/EC,第 10 章),把”修一块盘”的事交给上层软件。单机 RAID 仍活在传统 DB 服务器和存储阵列里。
第七章 性能测量:IOPS、吞吐、延迟与 fio 实操
这章是前六章的”变现”——学完概念后,你要能亲手打出数字、并能审计别人的数字。也是回看”40GB/s”争论时的收官武器。
7.1 三大指标与它们的关系
| 指标 | 含义 | 数据库类比 |
|---|---|---|
| IOPS | 每秒 IO 次数 | QPS |
| 带宽(Bandwidth/吞吐) | 每秒字节数 GB/s | 每秒处理的数据量 |
| 延迟(Latency) | 单次 IO 耗时,看 P50/P99/P999 | RT 分布 |
换算公式:带宽 = IOPS × 块大小(bs)。这一个公式立刻解释一个反直觉现象:同样打满 7 GB/s,用 1MB 块只需 7000 IOPS,用 4KB 块需要 175 万 IOPS——顺序大块测的其实是带宽,随机小块测的其实是 IOPS。厂商宣传的”700 万 IOPS”和”14 GB/s”是同一张盘在不同负载下的两副面孔。
第四个常被忽略的维度:队列深度(QD)。单线程发一个请求、等回来、再发下一个,哪怕盘再快也只有”1/延迟”的吞吐。要打满盘必须多请求并发灌进去(fio 用 numjobs/iodepth,NVMe 的 64K 队列就是为此准备)。存储圈的黑话:深度大吞吐高但延迟涨(排队),深度小延迟低但打不满——这就是吞吐-延迟曲线永远在权衡的形状,和数据库并发-RT 的权衡完全同构。
7.2 fio:磁盘界的 sysbench
fio(Flexible IO Tester)是事实标准。参数→概念映射:
| fio 参数 | 作用 | 对应概念 |
|---|---|---|
| —rw=read/randread/write/randwrite | 顺序/随机读写 | 负载模型 |
| —bs=1M / 4k | 块大小 | 测带宽还是测 IOPS |
| —direct=1 | 绕页缓存 | 必加,否则测的是内存 |
| —numjobs=4 | 4 个线程并行 | 队列深度 |
| —iodepth=32 | 每线程在途请求数 | 排队长度 |
| —runtime=60 —time_based | 固定时长跑 | 取稳态样本 |
| —group_reporting | 多线程汇总成一个数 | 报口径 |
四个基础实验:
# ① 顺序大块读:测单机带宽上限(对应"40GB/s"类宣称的口径)
fio --name=seqread --rw=read --bs=1M --direct=1 \
    --numjobs=4 --iodepth=32 --size=4G --runtime=60 --time_based \
    --group_reporting --filename=/path/to/testfile

# ② 随机 4K 读:测 IOPS(OLTP 的真实压力形状)
fio --name=randread --rw=randread --bs=4k --direct=1 \
    --numjobs=4 --iodepth=32 --size=4G --runtime=60 --time_based \
    --group_reporting --filename=/path/to/testfile

# ③ 随机 4K 写:测稳态(看消费级盘 SLC cache 跳水)
fio --name=randwrite --rw=randwrite --bs=4k --direct=1 \
    --numjobs=4 --iodepth=32 --size=4G --runtime=600 --time_based \
    --group_reporting --filename=/path/to/testfile

# ④ 混合 7:3 读写:最接近业务
fio --name=mixed --rw=randrw --rwmixread=70 --bs=8k --direct=1 \
    --numjobs=4 --iodepth=32 --size=4G --runtime=60 --time_based \
--group_reporting --filename=/path/to/testfile读数要点:看 fio 输出的 read: IOPS=xxx, BW=xxx 之外,一定要看 lat (usec) 的 avg 和 99.00th%——IOPS 高但 P99 抖上天的盘,做数据库主存是灾难。
7.3 稳态:测试前先把盘”打服”
第 3 章说过 SSD 有 SLC cache 和 GC,全新盘的首次测试会看到”巅峰速度”,毫无参考意义。标准流程是先填一遍盘再测(precondition):
# 预热:顺序写填满整盘 1~2 遍,逼出 FTL 真实工作状态
fio --name=prep --rw=write --bs=1M --direct=1 --filename=/dev/nvmeXn1 \
    --size=100% --loops=2
企业级测试规范(SNIA PTS)要求写两遍以上再取数。面试里说出”我看的是稳态数字,不是开箱数字”这句话,直接把你和背参数的人区分开。
7.4 报数合规:三问的落地模板
结合第 1 章的三问,任何数字发布前的自检清单:
- 测试点:direct=1 了吗?测的是裸盘还是文件系统上?应用层又另测了吗?
- 聚合口径:几块盘、几台机、numjobs/iodepth 多少?单盘 or 单机 or 集群(dist)?
- 负载匹配:rw 类型、bs 大小、读写比例、是否稳态(先填盘了吗)、跑了多久、P99 延迟多少?
标准报数句式(背下来直接用):
“40 GB/s 是单台服务器 8 张 PCIe 4.0 NVMe 企业盘、fio 顺序读 bs=1M、direct=1、numjobs=8、预热后稳态的单机聚合值;P99 延迟 xx us。应用层(KVCache 真实块大小 64KB 前缀命中负载)实测 xx GB/s,瓶颈在 [网络/序列化/CPU]。”
对照这个模板,你就能秒判社区里任何带宽宣称的成色:缺”单盘还是聚合”说明是外行;缺”稳态”说明没做过正经测试;缺”负载形状”说明没想过真实场景。40GB/s 这个数本身不惊人——惊人的一直是口径的清晰度。
第八章 网络存储通道:RDMA 与”瓶颈常在网”
单机故事讲完了。要把 N 台机器的盘拼成一个集群(这就是 KVCache store / 分布式数据库的形态),机器之间搬运数据的通道就成了新主角。这章讲清楚:为什么”分布式带宽”的第一瓶颈往往不在盘、在网。
8.1 传统 TCP 的代价
普通网络(TCP + 以太网)传一份数据的路径:
应用缓冲区 → 拷贝到内核 socket 缓冲 → 协议栈封装(TCP/IP)→ 网卡
     —————— 物理线路 ——————
网卡 → 协议栈解封装 → 拷贝到应用缓冲区
两次内存拷贝 + 两次协议栈处理 + 多次中断。单看一笔没问题,但在 40GB/s 量级时,CPU 光做协议栈和拷贝就烧满了,传输通道成了整条链路最窄处。类比:盘是 8 车道高速公路,TCP 是每个包都要过两道安检。
8.2 RDMA:远端内存直接读写
RDMA(Remote Direct Memory Access):网卡自带智能,应用预先注册一块内存区,之后一方可以直接读写对方网卡登记的内存区域,全程不经过任何一方的操作系统内核——没有协议栈、没有内核拷贝,延迟从几十微秒降到 1~5 微秒,CPU 几乎零参与。
类比:TCP 是”寄快递,双方前台签收”;RDMA 是”你有我家钥匙,直接从我桌上拿东西”——所以我必须先”授权登记你家地址”(内存注册),你也只能拿登记过的东西(保护边界)。
RDMA 的三种操作(高性能系统常提):
- SEND/RECV:还是消息模型,但零拷贝;
- WRITE:一方直接写对方内存(单向、零通知,最快),常用于”把 KV 块直接推进对端预注册好的接收区”;
- READ:一方直接读对方内存(单向)。KVCache store 里 decode 节点”拉 KV”常用 RDMA READ,正是吃它的单向零开销。
物理载体两种:InfiniBand(专用线,延迟最低、贵)和 RoCE(RDMA over Converged Ethernet,普通以太网跑 RDMA,数据中心主流,便宜但需要无损网络配置 PFC/ECN——否则”以太网丢一个包,RDMA 重传整条消息”,性能雪崩)。
带宽预算:100Gb/s 网卡 = 12.5 GB/s,200Gb = 25 GB/s。单台 8 盘 40GB/s 的机器,如果只有一张 100Gb 网卡,对外的可用带宽被网络掐到 12.5GB/s。这就是”单机 40GB/s”和”集群对外服务带宽”之间巨坑的来源——盘打得再快,网就那么宽。这就是为什么那些宣称聚合 40GB/s+ 的系统要插 2~4 张 200G 网卡。
8.3 NVMe-oF:把”盘的方言”搬到网上
第 4 章提过:NVMe-oF 把 NVMe 协议报文通过 RDMA(或 TCP)转发,让 initiator 直接说”盘的语言”访问远端盘,省掉远端文件系统一层。意义再强调一次:每省一层衙门,延迟少一截、CPU 省一块。分布式存储里”计算节点直读存储节点裸盘”的方案多走这条路。
8.4 零拷贝全家福(本机侧的配合)
除了 RDMA,本机内减少拷贝的常见武器,一并认清:
- sendfile / splice:文件→网络直接管道(静态文件服务标准姿势);
- mmap:文件映射内存省一次读拷贝(第 5 章);
- DMA:一切的基础——网卡和盘本来就能直接访问内存,绕过 CPU 搬运。RDMA 的本质是”把 DMA 的能力扩展到了网络上”。
8.5 本章结论:分布式带宽的记账公式
把第 4 章”单机带宽记账”扩展到集群:
集群有效带宽 ≈ min(
   N × 单机盘带宽,            # 介质总供给
   N × 单机网卡带宽,          # ← 常是短板(12.5/25 GB/s 每机)
   交换机集群总容量,          # 交换机 radix × 端口带宽
   副本/EC 放大系数,          # 3 副本把客户端可见带宽除以 3(下一章)
   CPU 序列化/校验开销
)
所以看到”集群聚合 xx GB/s”的宣称,先做除法:单机对外带宽 × 机器数 ÷ 副本数,对不上号就有鬼。这个心算工具足够你审阅 90% 的分布式存储宣传。
第九章 分布式存储基础:把 N 台机器的盘拼成一个系统
单机的盘再多也有上限,生产存储必须是分布式的:几十上百台机器、每台几块盘,用一个软件层拼成”一台逻辑上的大存储”。这章讲清这个软件层的通用骨架——学完后看 HDFS、Ceph、3FS 都是同一些模式的不同排列组合。
9.1 为什么分布式:可用性与扩展性
盘会坏,机器会断电,机房会断网。单机无论怎么 RAID,整机一挂全完。分布式的两个承诺:
- 可用性:坏任意一台(甚至几台),数据不丢、服务不停;
- 扩展性:加机器 → 容量和带宽线性涨(scale-out),这也是”聚合带宽”数字随集群规模可以任意的根本原因——集群数字的含金量必须除以机器数再看。
9.2 通用骨架:元数据层 + 数据层
几乎所有分布式存储都是”控制面 + 数据面”分离:
- 元数据层(控制面):回答”我要的数据块 X 在哪台机器哪块盘上”。单点则成瓶颈/故障点,所以要么用 Paxos/Raft 复制的小集群(GFS/HDFS 的 NameNode、3FS 的 metadata),要么全分布式哈希表(Ceph 的 CRUSH)。类比:这就是数据库 catalog/字典的分布式版本,且为了可用必须自己多副本。
- 数据层(数据面):真正搬字节的 worker 进程,每台机器跑一个,管本地 NVMe。IO 路径追求最短(本章的关键是:数据流不过元数据节点,元数据只指路——控制和数据分离,否则元数据节点成为 IO 热点)。
分片单位(chunk/block/shard)的典型大小是 MB 级:太小元数据爆炸,太大负载不均衡。类比数据库的分区表粒度选择。
9.3 冗余:三副本 vs 纠删码(EC)
数据放 N 台机器上,怎么防机器坏?
三副本(3x replication):每块数据写三份放三台机器。优点:读可以挑最快的副本,实现简单,修复快(任何一台坏,从另外两台拷)。缺点:空间利用率 33%,写的网络放大 3 倍。数据库集群的多数派、KVCache store 的默认姿势。
纠删码(Erasure Coding, EC):用数学换空间。把数据切成 k 份、算出 m 份校验(记 EC(k+m)),任意丢 m 份都能解方程恢复。例如 EC(8+3):11 份存储 8 份数据,利用率 73%,且坏 3 台不丢。缺点:坏一份要读剩下 8 份来恢复(修复成本高,HDD 集群”修复风暴”事故常客);小写入要读旧分片重算校验(读改写放大,所以 EC 常只用于冷数据/大文件)。类比:RS 纠删码就是 RAID 5/6 的推广版,只是校验分布到全集群而不是单机。
成本敏感的大规模系统(对象存储的冷层)几乎全是 EC,热层和写密集层用三副本——又是冷热分层。
9.4 一致性:副本之间怎么不打架
三副本写下去必然面临”写到第二台成功第三台失败,算不算写成功?“分布式的一致性从这里展开。收敛到你需要掌握的最小集合:
- 强一致/线性一致:读到的永远是最新写。代价是所有写过多数派(quorum)。分布式数据库(Spanner、TiDB)在这档。
- 最终一致:副本间异步追赶,短窗口读旧数据。对象存储、缓存系统在这档。类比:异步复制的主从,复制延迟窗口内从库读旧数据——你早就会这个概念。
- CAP 的实用读法:网络分区(P)必选,剩下在 C 和 A 之间挑。存储系统大多挑 CP(宁可拒绝服务不给脏数据),缓存系统常挑 AP。
- Quorum(R + W > N):写 W 个副本算成功、读 R 个副本取最新,只要 R+W>N 就能保证读到最新。数据库人可以直接映射成”半同步复制的 ack 票数”。
9.5 心跳、故障与再平衡
维持一个”永远有机器坏”的集群的日常机制:
- 心跳:worker 定期向元数据层报到,超时(典型 30s~几分钟)判死;
- 故障恢复:判死的机器上的副本从其他副本拷贝到新机器——注意这挤占正常业务带宽(网络又成了瓶颈),大集群要限速恢复;
- 再平衡(rebalance):新机器加入后旧数据搬一部分过去,让负载均匀。类比:数据库分片间的数据迁移/分裂。
一个隐含的时间问题叫脑裂:两拨机器互相认为对方死了、各自当老大。解法是多数派选举——挂掉的少数派自动失效。这就是为什么 quorum 里 2/3 活着才干活,2 节点挂 1 个后为什么直接不能写。
9.6 三大经典系统对号入座
| 系统 | 形态 | 关键点 |
|---|---|---|
| HDFS | 分布式文件系统 | NameNode 元数据 + DataNode 数据;三副本;一次写多次读;大数据时代的地基 |
| 对象存储(S3/Ceph RGW) | 键值对象 | 海量小对象、EC 冷层、REST 接口;互联网图片视频的标准答案 |
| Ceph | 统一存储 | CRUSH 算法算数据位置(去中心化元数据);块/文件/对象三接口合一 |
| 3FS | 高性能文件系统 | RDMA + NVMe 直通,为 AI 训练/KVCache 设计(第 12 章主角) |
9.7 聚合带宽的诚实算法
把第 8 章的记账公式补全,分布式聚合带宽宣称的审计步骤:
单机贡献 = min(单机盘聚合带宽, 单机网卡带宽)
集群聚合 ≤ N × 单机贡献 ÷ 副本数(或 × EC 写放大)
再减去恢复流量 / 再平衡流量的抢占比
例:100 台机器、每台 8 盘 40GB/s 但网卡 25GB/s、三副本 → 理论聚合 ≈ 100×25÷3 ≈ 830 GB/s。假如宣称”500GB/s”要打问号时,就用这个公式先心算。“dist 带宽”必须报机器数和副本数才有意义——这就是评论区追问”是盘还是 dist”的深层理由。
第十章 复盘:存储如何塑造了数据库
这章把你最熟悉的数据库设计逐个”回炉”到前九章的介质知识里——每一条都解释成”被某层存储特性逼出来的设计”。这是数据库背景学存储的最大红利:你不是新学,是给你已有的知识补上因果链。
10.1 页(page)大小的因果链
为什么 InnoDB 是 16KB、PG 是 8KB?因为 HDD 一次寻道 10ms 极贵,“一次寻道多拿数据”是铁律,所以页要大;但页太大又伤随机更新的写放大(改 1 字节重写整页)和内存占用,所以停在 816KB 的折中。SSD 的 NAND page 是 4~16KB,DB 页继续对齐它避免”一次读拿两页”的浪费。页大小 = 介质最小单位与写放大之间的折中。
10.2 B+ 树:为”减少随机 IO”而生
HDD 随机读 10ms、顺序 0.2GB/s,相差三个数量级。B+ 树的全部设计都服务于”把任意点查压缩到尽量少的随机读”:
- 矮胖多叉:每层一次随机读(~10ms),4 层树 = 40ms 的固定税。叉数越多(页内密排 + 页大),树越矮。树高就是随机 IO 次数,这是它的全部 KPI。
- 聚簇索引:把行数据直接放在主键 B+ 树的叶子页里,主键查找只走一棵树;二级索引叶子存主键再回表——每一步都是”少寻一次道”的执着。
- SSD 时代的松动:随机读不再 100 倍惩罚,B+ 树的”随机读税”从 10ms 降到 100us,页内不必再那么极端地”密”。但 B+ 树没被淘汰,因为原地更新 + 立即可读(读放大低、无 GC)在点查/短查询负载上仍占优。
10.3 LSM:为”把随机写变成顺序写”而生
B+ 树的代价在写:每次更新都可能改任意树中任意页 = 随机写(HDD 上 100 倍惩罚,SSD 上烧 FTL 寿命)。LSM(RocksDB/LevelDB/HBase/许多 KVCache 元数据层)反过来:
- memtable → 不可变 SST 文件 → 后台 compaction:写入只追加到内存表,刷盘是整段顺序写,compaction 也整段整段搬(顺序)。写路径永远顺序。
- 代价转移为读放大(要查多层,加 bloom filter 缓解)和 compaction 的后台 IO(正是它像极了 FTL 的 GC——同一套物理约束逼出同一套方案,第 3 章埋的伏笔在此收口)。
- 拓扑细节:Leveled compaction 空间放大小但写放大大,Tiered 相反——工程上永远在三个放大系数(写/读/空间)间挑两衡一。
- 选型经验:写多读少/流式写 → LSM(HBase、KVCache 元数据);点查+范围扫+频繁原地更新 → B+ 树(MySQL/PG)。现在很多”新硬件”数据库混合两者。
10.4 WAL 与 fsync:持久化的最后一公里
前 5 章的页缓存知识在这里变现。数据库的 ACID 之 D 全靠这一套:
- 修改先以逻辑形式顺序追加写进 redo log(顺序 = 快,任何介质上都是);
- fsync 之前,“已写”不等于”已持久”(页缓存还在内存里);
- commit = 把这次事务的 redo fsync 落盘才向客户端回 ack——这就是
innodb_flush_log_at_trx_commit=1的语义;调成 2 就是”只写 OS 缓存、每秒才 fsync”,机器断电丢 1 秒事务,内核崩溃不丢——这个经典参数每一档的差别,正是第 5 章页缓存/ fsync 层级的直接应用。 - 数据页本身脏了由 buffer pool 慢慢刷(checkpoint),坏了就用 redo 重放——“日志先行,数据页异步收敛”和文件系统的 journal 思想(第 6 章)同宗。
group commit:多个并发事务的 fsync 攒批一次落盘,摊薄每次 100us~ms 级的固定成本——和 io_uring 的批量提交(第 5 章)是同一思想,也是数据库人最快理解高性能 IO 的桥。
10.5 doublewrite:文件系统不懂 SSD 的”半页”问题
InnoDB 要写一个 16KB 页,交给文件系统后底层可能按 4KB 扇区分几次写,断电写一半 = “页撕裂”(16KB 的新页旧页混合体)。redo 重放假设”页要么旧要么新”,撕裂页把恢复逻辑直接击穿。而 ext4 的 journal 只保文件系统自己的元数据(第 6 章结论),不管你文件内容的原子性。解法 doublewrite:先把页连续顺序写到一块”备份区”再写正式位置,恢复时从备份区捡完整页。又是一次介质/软件层语义缺口逼出来的设计。SSD 时代的消解:有些 FS 提供原子写、NVMe 有 atomic write 特性,PG 16 的Relation Deduplication/新内核 atomic write 特性都在试图淘汰 doublewrite。
10.6 buffer pool 与冷热分层:金字塔的中间层
第 1 章金字塔里”内存比盘快 1000 倍”的那个数量级,就是 buffer pool 的存在理由。而它的一切机制都是分布式存储的预演(第 9 章):
- LRU / CLOCK 淘汰 → 分布式缓存的 eviction 策略
- 脏页 + checkpoint → write-back cache + 后台刷盘
- 冷热页分离(如 InnoDB 的 young/old 子链)→ KVCache 的热前缀优先驻留
- 预读(检测顺序访问多读几页)→ 分布式系统的 prefetch
10.7 一张因果总表
| 数据库设计 | 被哪层存储特性逼出来的 |
|---|---|
| 16KB 页 | HDD 寻道贵 + NAND page 对齐 |
| B+ 树矮胖 | 随机 IO 一次 10ms(HDD)/100us(SSD) |
| 顺序 WAL | 任何介质顺序写远快于随机写 |
| fsync 语义 / trx_commit 参数 | 页缓存 write-back 不等于持久 |
| O_DIRECT | 页缓存与 buffer pool 双重缓存 |
| doublewrite | 扇区级非原子写 + redo 假设页原子 |
| LSM / compaction | 追加写介质友好 + FTL 同款约束 |
| group commit | fsync 固定成本高,批摊 |
| 冷热分层 / 归档表空间 | 介质价格-性能差几个数量级 |
| 分布式架构的多数派/副本 | 第 9 章:机器必坏,冗余必做 |
学到这,你已经完成了”存储知识 → 数据库知识”的双向翻译。最后一章把它推进到 AI 时代的新场景。
第十一章 KVCache Store 与 AI 时代存储
这是全书的终点。LLM 推理把一种全新的负载抛给了存储系统,这个负载的每个特点你都能用前十章的知识点解释。
11.1 背景:PD 分离与 KV Cache
LLM 推理分两阶段:
- Prefill:处理整段 prompt,算出每一层的 KV Cache(每层每个 token 的 Key/Value 向量缓存,transformer 自回归推理的副产品)——计算密集,一批 GPU 干;
- Decode:逐 token 生成,每一步都要回读全部历史的 KV——显存带宽/容量压力巨大,另一批 GPU 干。
把两阶段拆到不同集群(PD 分离,disaggregated prefill-decode)是当前主流架构,好处是两边各自扩容、互不抢资源。而 KV Cache 有个金子般的性质:相同前缀的 prompt,KV 可以完全复用(系统 prompt、文档开头、多轮对话的历史——都是重复前缀)。
于是产生了 KVCache Store:prefill 算好的 KV 落到一个分布式存储集群,decode 端按前缀命中后拉走直接续算,省掉重复 prefill 的算力。它是”算力太贵,用存储换”的产物——和你熟悉的一切缓存系统共享同一条经济学。
11.2 架构四层(对照第 9 章骨架)
元数据层:前缀 → KV block 位置映射(内存哈希/前缀树 + Raft 持久化)
数据层:  KV block 分布式 NVMe 集群 + RDMA 直传(io_uring/SPDK 本地 IO)
策略层:  驻留/淘汰(LRU+热度)、冷热分层(显存→内存→NVMe 三级)
接口层:  store/load API,对接 vLLM/SGLang 的 KV 管理器
和第 9 章”元数据 + 数据 + 副本 + 淘汰”完全同构——KVCache store 就是一个专门为”KV block”优化的分布式 KV 数据库,其中元数据层本身就是个小型 LSM/哈希引擎。
11.3 为什么 KVCache 负载”特殊”(用前十章逐条解释)
这就是 fio 数字会高估它的原因,每条都是旧知识:
- 块是”中等大小”:一个 KV block 典型 16
512KB(由 16128 个 token 的 KV 组成),不是 fio 的 1MB 大块也不是 4KB 小块。第 7 章公式”带宽 = IOPS×bs”——中等块同时考验 IOPS 和带宽,是两头都沾的难度。小块还吃不满顺序带宽(第 2 章顺序优势吃不到)。 - 访问模式是前缀匹配:按 prefix hash/前缀树找命中区间,读是”跳跃读”——命中区间不同 token 数、不同层,地址跳跃,非 fio 的均匀随机也非纯顺序。
- 网络是命门:decode 端拉 KV 走 RDMA,100G 网卡 12.5GB/s(第 8 章)掐着脖子。就算 store 端盘能吐 40GB/s,出网就 12.5。这就是为什么这类系统都堆 200G/400G 网卡。
- 热点前缀 skew:热门系统 prompt 全网复用 → 少数前缀极高命中率 → 局部盘/局部节点热点(第 3 章 FTL 热点、第 9 章 rebalance 的老问题)。
- 消费端限速:decode 集群把 KV 装进 GPU HBM 的速度、PCIe 转接(第 4 章 lane 预算)可能比存储还慢——全链路最窄处常常根本不在盘。
11.4 三个代表系统
- DeepSeek 3FS:高性能分布式文件系统,为 AI 训练/推理数据面设计。八卦要点:RDMA + NVMe 直通(io_uring/SPDK)、CRAQ 链式复制的元数据、宣称 180 TiB/s 聚合读——审计它:约 1800 台 × 8 盘 PCIe 5.0(单机 ~100GB/s 理论)量级,口径是集群聚合,跟”单机 40GB/s”完全两个层面的数字。这正好演示了”不报口径的带宽数字没有可比起”。
- Mooncake(清华 + Moonshot/Kimi):KVCache 优先的存储系统,transfer engine(RDMA 拓扑感知传输)+ 可共享的 KV 池,业界最贴近”KVCache store”原型的参考。
- LMCache / vLLM KV connector:推理引擎侧的对接层,把”显存 → 本地内存 → 远端 store”的多级缓存管起来——第 10 章 buffer pool 冷热分层的 LLM 版。
11.5 学习路线收官
- 读:3FS 博客(拆聚合数字到单机单盘)、Mooncake 论文(架构四层原型)、vLLM KV connector 文档(接口层)。
- 跑:第 7 章 fio 四个实验,亲手看顺序/随机/稳态的差距。
- 串:回看 InnoDB 的 redo/doublewrite,用第 10 章因果表把每个设计讲给自己听一遍。
- 谈资:以后遇到任何带宽宣称,三问 + 带宽记账公式 + “稳态”一句,足够你在任何讨论里站住。
全书完。你已经从”NVMe、PCIe 是啥”走到了能审计 KVCache store 性能宣称的位置——这条路没有跳步,每一层都是下一层的地基。